RAG 的混合检索:什么时候用,怎么选
向量检索和 BM25 各自看不见什么,两路结果用 RRF 还是加权,几个参数怎么定,什么时候接重排,以及哪些问题不该交给检索。
RAG 的混合检索:什么时候用,怎么选
学 RAG 之前,我以为检索是一条固定的流水线:录入资料,切片,Embedding,去向量库里算相似度,拿回 top-K,模型组织一下语言。
真做了一个之后,回答和问题经常对不上,我才知道中间每一步都有选择要做。
这篇讲其中一步:混合检索。它是什么,什么情况下需要它,两路结果怎么合,参数怎么定,以及什么时候它帮不上忙。例子和数字来自我自己的小项目 EasyRAG,一个个人知识库问答系统,向量库用 Chroma,Embedding 用 BGE-M3,关键词检索用 rank_bm25 加 jieba。项目很小,评估语料只有 29 篇,所以数字只用来说明道理。
两种检索各自看不见什么
向量检索看的是意思像不像,BM25 看的是字面有没有。
先说向量检索。Embedding 模型把一段文字变成一串数字,可以理解成在一张"语义地图"上给它标了个坐标,意思相近的文字坐标也近。检索时把问题也变成坐标,找离它最近的几个片段。
它的长处是不怕换说法。我的库里有一篇 LCEL 的笔记,我故意不提这个词去问:
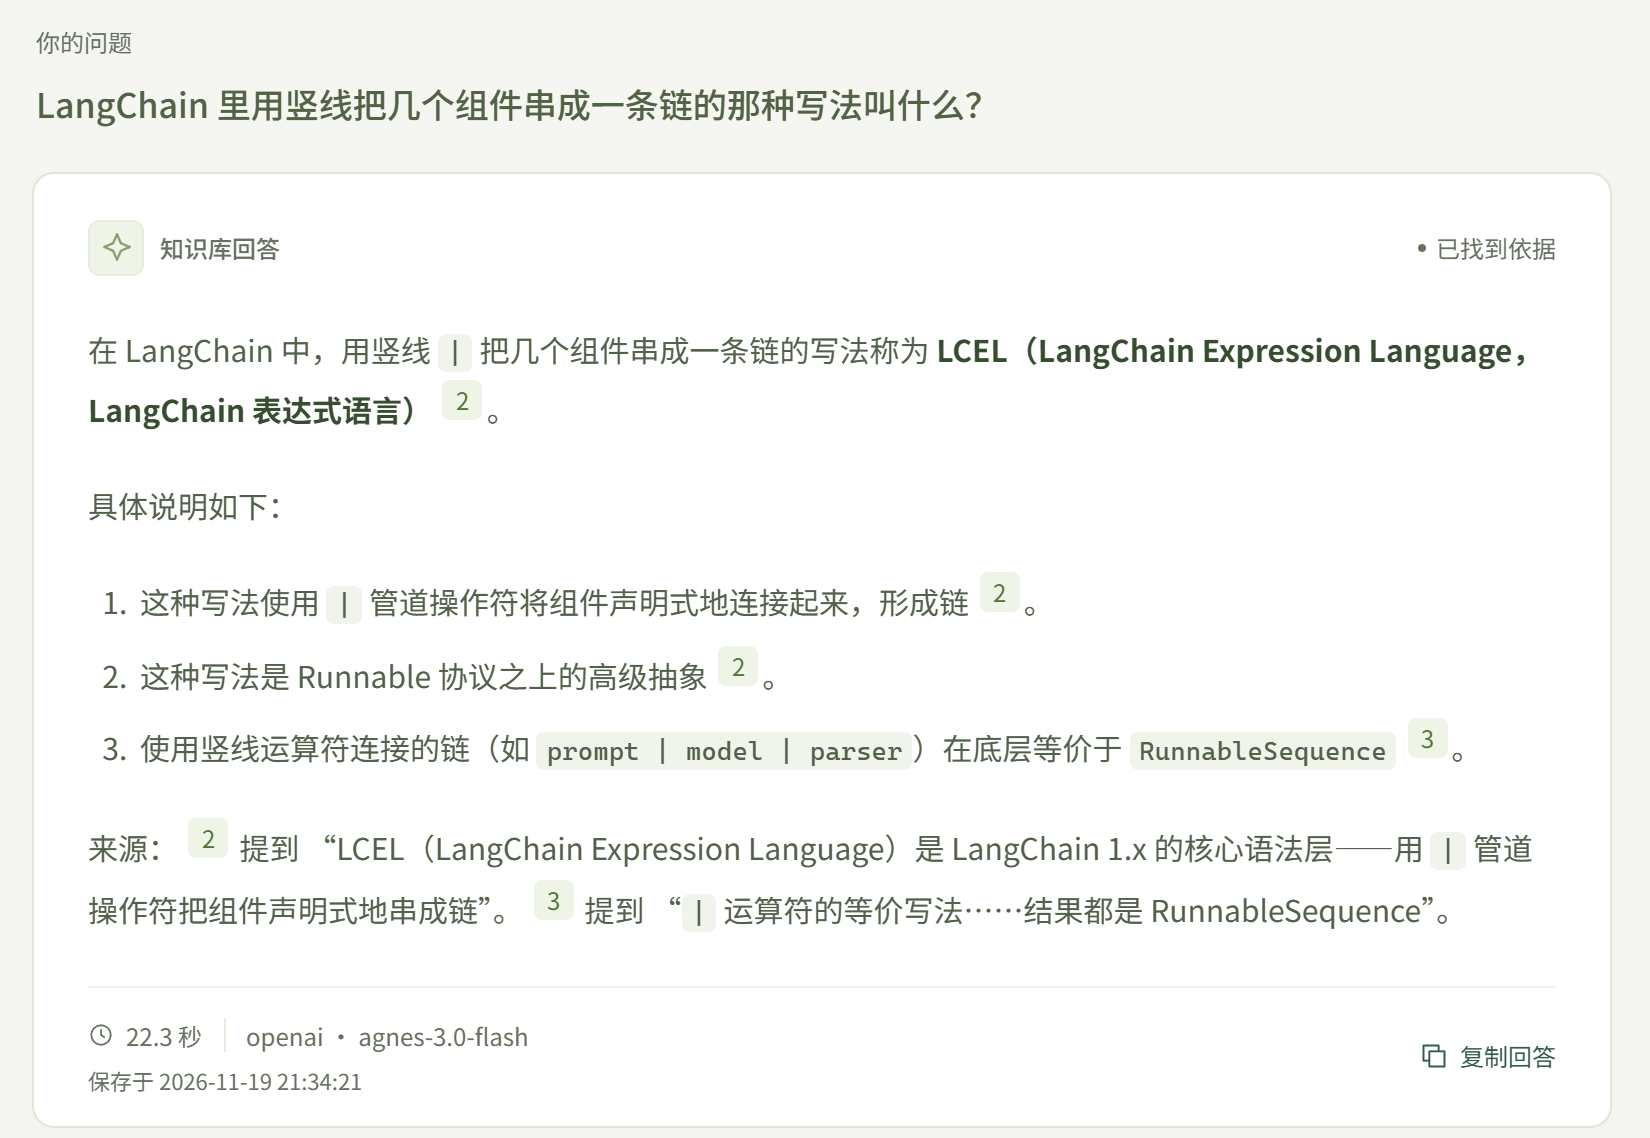
问题里只有"用竖线把几个组件串成一条链",照样找到了 LCEL 那篇。
它的短处是只认"主题相近",不认"原话就在这"。项目评估里有一道题:文件写入返回成功后为什么断电还会丢数据,怎么强制落盘。库里有一张讲 OS Buffer 的短卡,原文就写着 fsync,几乎逐字对得上。纯向量检索却把它排到了前十名之外,排在前面的是 Redis 持久化、过期 Key 两篇长文的片段。它们也在讲"数据落盘",主题很近,而且长文切出来的片段多,数量上就把短卡挤没了。
模型拿到这些 Redis 片段,生成了一个引用编号全部合法的回答。整条链路没有任何报错,只是答的不是用户问的那篇。
再说 BM25。它是关键词检索里最常用的打分方法,我把它理解成一个会排序的 Ctrl+F。它给片段打分时看三件事:
- 问题里的词在片段里出现了几次。出现越多分越高,但会封顶,出现 20 次不会比出现 5 次高出四倍。
- 这个词在整个库里稀不稀有。
fsync这种少见的词很值钱,"数据"这种到处都有的词不值钱。 - 片段有多长。同样命中一次,短片段的得分比长片段高。
和 Ctrl+F 一样的地方是都只认字面。上面那道题,BM25 一下就能把短卡捞出来,因为 fsync 稀有,短卡又短。
短处也在字面:对不上就是零分。用户说"竖线",原文写"管道操作符",用户说"落盘",原文写"持久化",BM25 都看不见。自己用还可以换个词重问,放到面向客户的问答助手上,口语化的问法到处都是。
什么时候需要混合
混合检索就是两路都跑,再把结果合起来。它不是默认就该上的东西,多一路就多一份分词、索引和调试。
我现在的判断方法是看语料和问题里有没有这几种情况:
| 情况 | 哪一路会吃亏 | 例子 |
|---|---|---|
| 问题里有命令名、函数名、错误码、型号、缩写 | 向量 | fsync、redis-check-aof |
| 库里长文和短卡混在一起,主题还重叠 | 向量 | 上面那道断电丢数据的题 |
| 用户的说法和文档的写法差得远 | BM25 | 口语提问、同义词 |
| 中英文混着问,或者有错别字 | BM25 | 文档写英文术语,用中文问 |
只占后两行,纯向量通常够用。只占前两行,而且用户都是会用准确术语的内部人员,纯关键词也能凑合。两边都占,就该上混合。个人知识库基本两边都占:笔记里全是命令和术语,提问的时候又很随意。
这张表是经验判断,真正的依据是失败题。我是先看到那道断电丢数据的题在纯向量下答错了来源,才加的 BM25。
两路结果怎么合
两路各返回一串排好序的片段,接下来的问题是怎么合成一串。
最容易想到的是加权求和:向量分数乘一个权重,BM25 分数乘一个权重,加起来排序。
它的麻烦在于两种分数不是一把尺子。余弦相似度挤在一个很窄的范围里,BM25 没有上限,问题长一点、命中的词多一点,分数就能差出好几倍。直接相加,结果基本只听 BM25 的。这就像把百分制和五分制的成绩直接相加,五分制那门考得再好也没用。
所以加权之前必须先归一化,把两种分数都压到 0 到 1 之间,然后再调权重。这两步都需要一批标注过的问题来校准。
另一种做法是 RRF(倒数排名融合)。它不看分数,只看名次。
RRF(片段) = 每一路里 1 / (k + 该片段在这一路的名次),加起来
某一路里没出现的片段,那一路就不加分。k 是常数,常用 60。
算一个小例子:
| 片段 | 向量名次 | BM25 名次 | RRF 得分 | 融合后 |
|---|---|---|---|---|
| A | 1 | 没出现 | 1/61 ≈ 0.0164 | 第 3 |
| B | 3 | 2 | 1/63 + 1/62 ≈ 0.0320 | 第 1 |
| C | 没出现 | 1 | 1/61 ≈ 0.0164 | 第 4 |
| D | 2 | 5 | 1/62 + 1/65 ≈ 0.0315 | 第 2 |
A 和 C 各自在一路里排第一,融合后却排在 B 和 D 后面。
RRF 奖励的是"两边都认可",而不是"某一边特别认可"。
EasyRAG 里的实现只有几行:
RRF_RANK_CONSTANT = 60

def fuse_rankings(rankings, *, rank_constant=RRF_RANK_CONSTANT):
    fused = {}
    for ranking in rankings:
        for position, identifier in enumerate(ranking, start=1):
            fused[identifier] = fused.get(identifier, 0.0) + 1.0 / (rank_constant + position)
    return sorted(fused, key=lambda identifier: -fused[identifier])
rankings 是两路各自排好序的片段 ID 列表,得分相同时保持先出现的顺序。
融合之后的顺序和向量相似度不再一致,这一点在真实返回里能直接看到。上面那个 LCEL 的问题,接口返回的前 5 个片段是这样的:
| 融合后名次 | 余弦相似度 |
|---|---|
| 1 | 0.601 |
| 2 | 0.592 |
| 3 | 0.532 |
| 4 | 0.554 |
| 5 | 0.514 |
第 3 名的相似度比第 4 名低。如果只按向量排,它们的位置应该对调,是另一路的名次把它推了上去。
两种方法怎么选,我的看法是:
- 没有标注数据,或者刚起步:用 RRF。它不用归一化,不用调权重,结果稳定。
- 有一批标注好的问题,并且明确想偏向某一路:可以试加权,因为它保留了"第一名比第二名强多少"这个信息。
RRF 的代价正是丢了这个信息。某个片段在向量那边遥遥领先,在 RRF 眼里也只是"第一名"。
我用的是 RRF。回到那道断电丢数据的题,融合之后 OS Buffer 短卡从前十之外升到了第 4。
几个数字怎么定
RRF 常被说成不用调参。它少了一个权重,但还有三个数要定。
k 取多少。 k 控制名次之间的差距。k 是 60 时,第 1 名得 1/61,第 2 名得 1/62,几乎一样。k 是 1 时,第 1 名得 1/2,第 2 名得 1/3,少了三分之一。所以 k 越大越看重"两路都出现",k 越小越看重"在某一路排得靠前"。60 是提出 RRF 的论文里用的值,大多数系统直接沿用。我没动它,因为没有哪道失败题是需要改它才能解决的。在三十道题上调一个系数,调出来的多半是过拟合。
每一路取多少条。 我是两路各取前 20。取得太浅,一个在向量那边排第 25 的正确片段就没机会被 BM25 拉上来。取得太深,后面的噪声也会参与融合。这个数跟着数据量走,我的库只有两百多个片段,20 已经够深。
最后给模型几条。 我取前 5。给多了模型要读的东西多,又慢又容易被无关内容带偏。给少了,排在后面的必要证据就丢了。那张短卡排第 4,如果只取前 3,混合检索等于白做。
中文还多一件事:分词。BM25 按词算分,英文有空格,中文得先切词,切得不好后面全错。我用 jieba 的搜索粒度分词,过滤掉"的""了""什么""怎么"这类虚词。
英文标识符要单独处理。redis-check-aof 这种命令名,分词器会在连字符处切开。我让它同时保留完整的词和拆开的部分,这样问全名和问其中一段都能匹配上。建索引和查询必须用同一套分词,否则两边的词对不上。
混合之后还要做什么
混合检索解决的是"正确的片段有没有进候选"。进了候选之后还有两个问题:顺序对不对,这些片段够不够回答。
顺序不对,接重排(rerank)。 重排模型把问题和每个候选片段放在一起读一遍再打分,比向量相似度准,也慢得多,所以只用在已经召回的几十条上。
什么时候该接它,看失败发生在哪:
- 正确片段在候选里,但排不进前几名:接重排。
- 正确片段根本不在候选里:重排没用,它只能调整顺序,不能把没召回的东西变出来。这时该改的是召回,也就是混合检索、切片或者查询改写。
我碰到的是后一种,所以先做了混合,目前没接重排。
够不够回答,要另外判断。 我原来以为设一个相似度阈值就行,低于某个分数就拒答。评估里有一组数字让我放弃了这个想法:一道库里有完整答案的题,最高相似度是 0.579。另一道库里只有相关背景、缺了主体的题,相似度是 0.588,反而更高。
相似度只能说明主题相关,说明不了内容够用。所以检索之后我加了一步,让模型先读候选,给出三种结论之一:资料足以回答、只能部分覆盖、没有相关内容。同时指出哪几个片段真的用得上,生成时只看这几个。
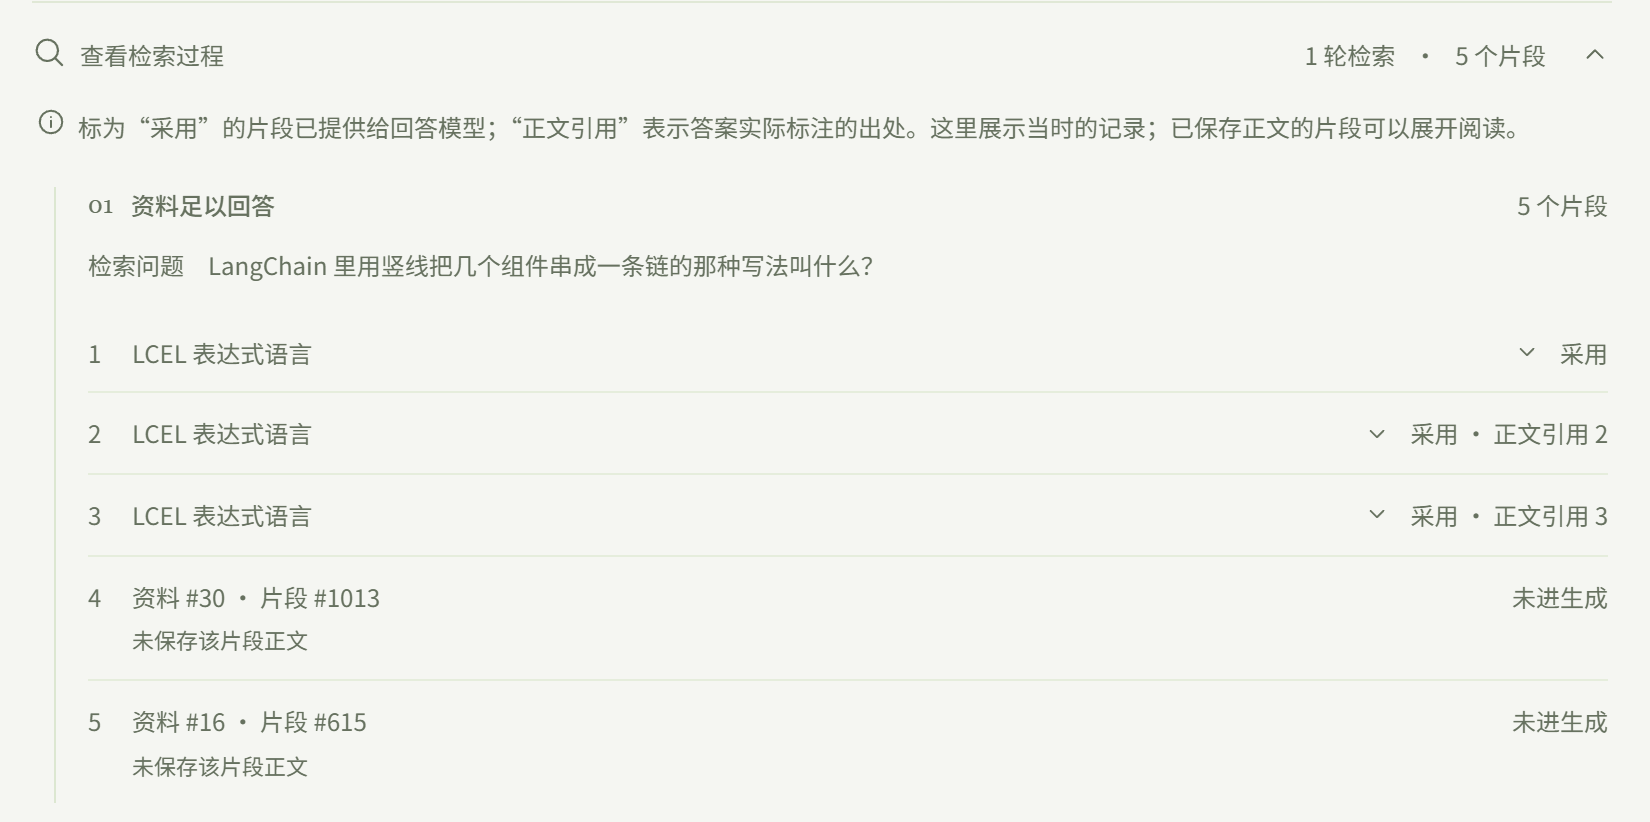
这是上面 LCEL 那个问题的检索过程。5 个候选里,前 3 个被采用,后 2 个没有送进生成。
这一步顺带解决了混合检索的一个副作用。BM25 会带进来一些字面沾边、其实无关的片段,筛掉之后它们不会干扰生成。评估里 32 道作答题共 160 个候选,最后送进生成的只有 76 个。
它也会出错。评估里两道"部分覆盖"的题,仍有一道被判成了资料充分。
速度方面,在我这个规模上检索这一段是毫秒级的,一次问答的时间绝大部分花在模型生成上。多跑一路 BM25 感觉不出来,多一次模型判定能感觉出来。
哪些问题不该交给检索
这是我绕得最远的一段。
有一类问题检索怎么都答不好:"库里一共有多少篇笔记""我刷了哪些算法题""概括一下整个知识库"。
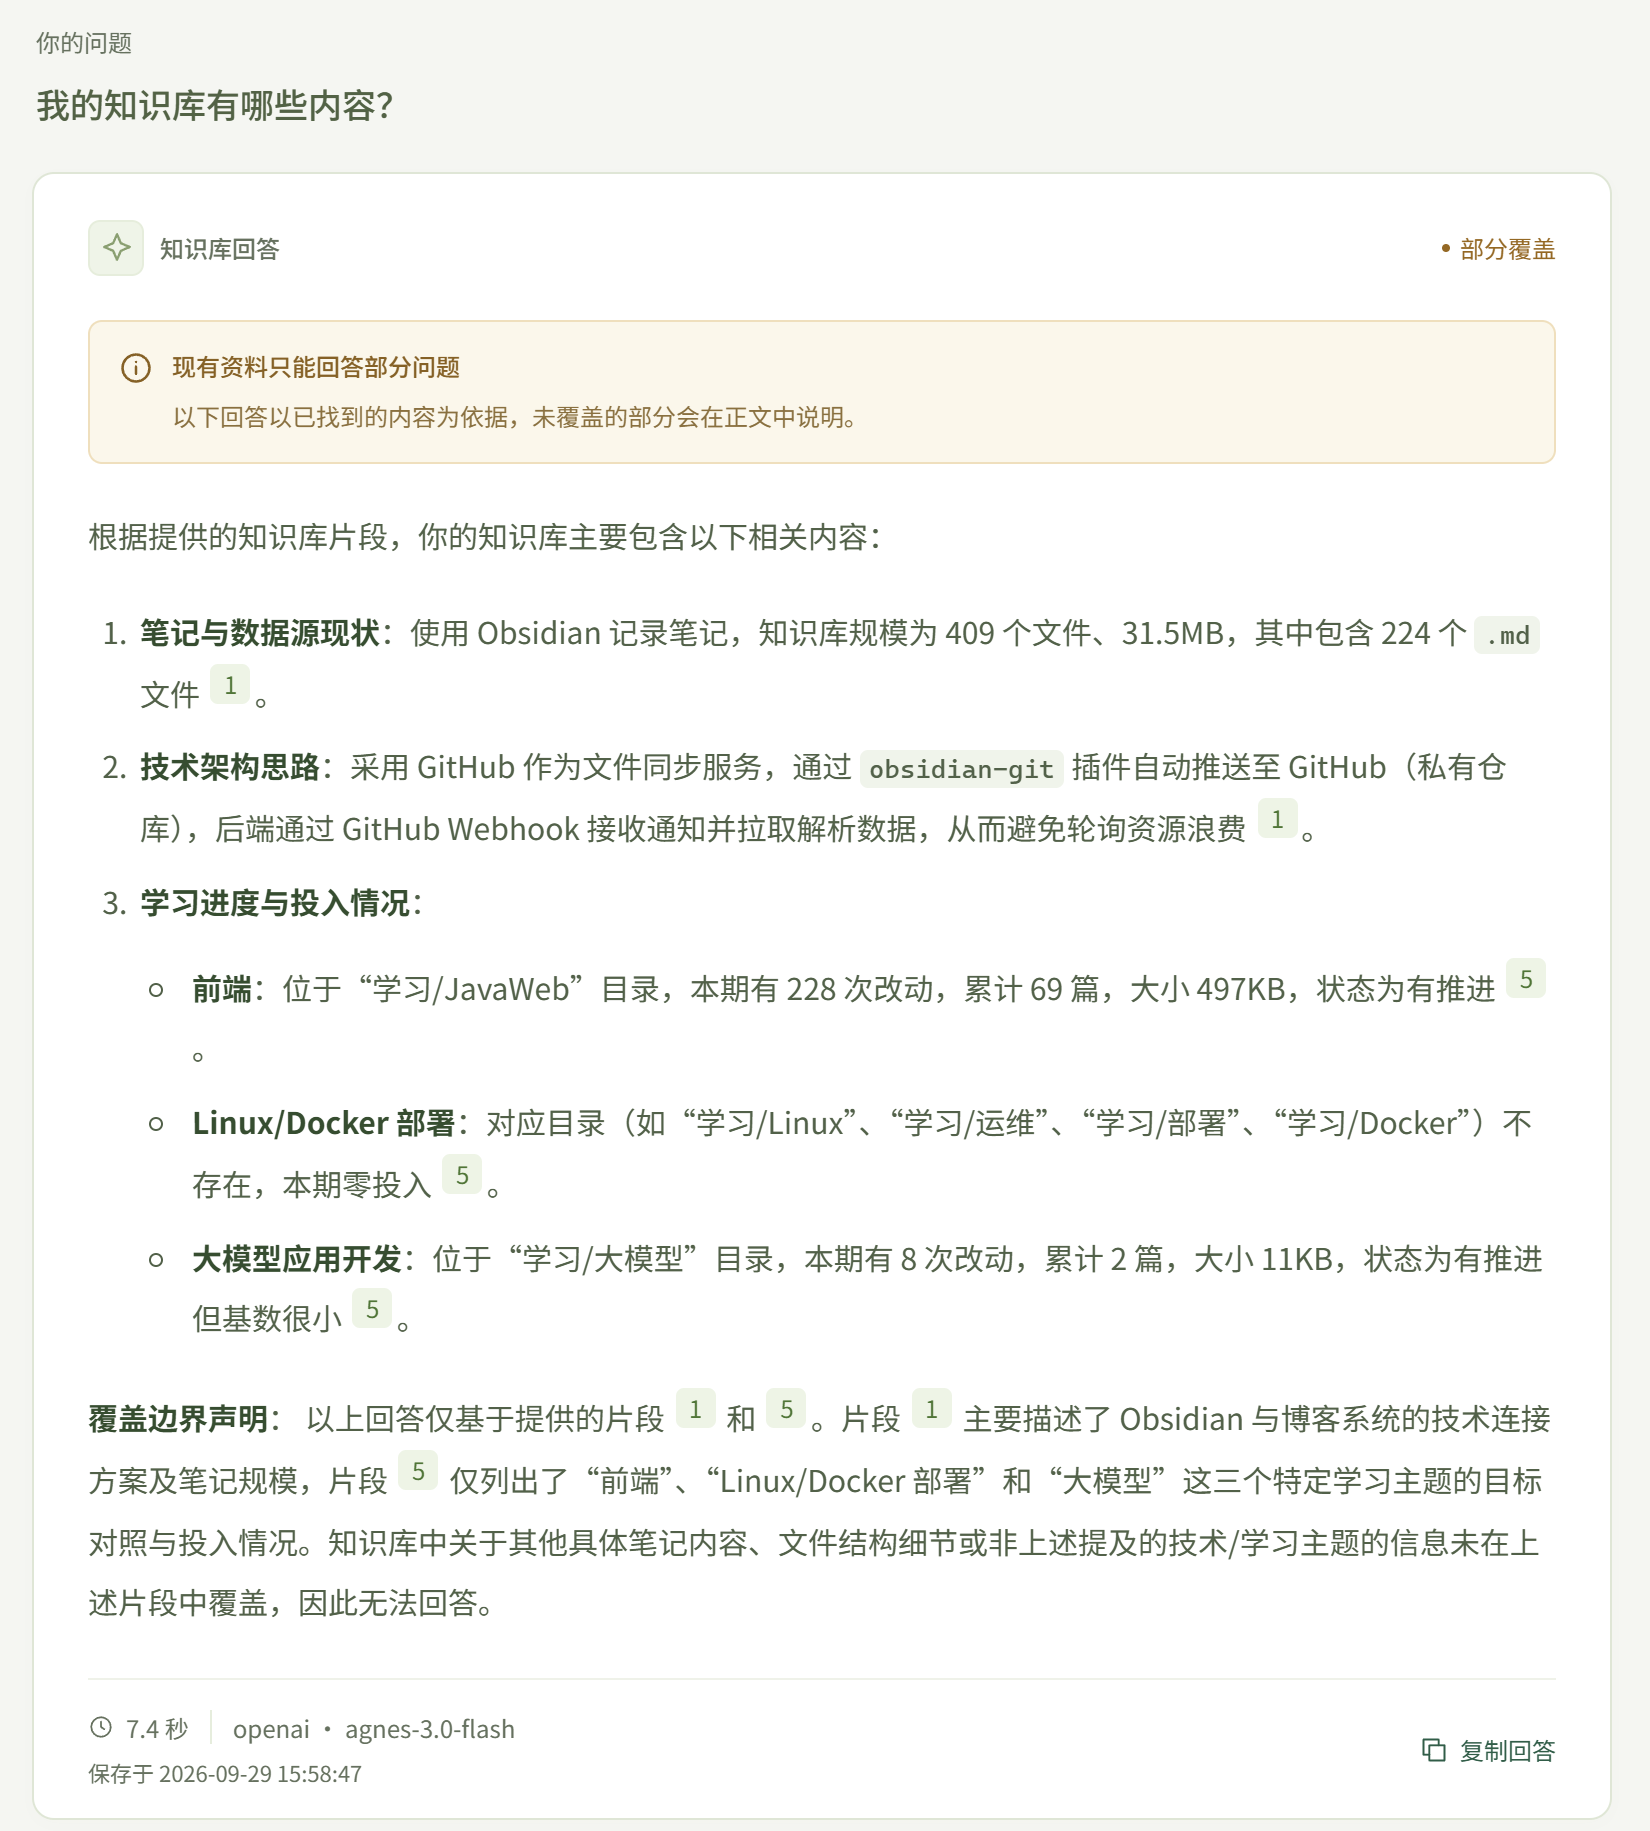
问"我的知识库有哪些内容",系统只能根据检索到的两个片段作答,然后老实声明其他内容没有覆盖到。它没有瞎编,但也确实没回答问题。
我当时想的全是怎么优化检索。给文件分类?按时间过滤?按标签过滤?
后来才想明白方向错了。RAG 做的事是把完整的资料切成小块,再挑出最像的几块。统计和全局类问题的答案不在任何一块里,它在"所有块加起来"里。检索做得再好,拿回来的也只是 5 个片段。
这类问题该走元数据。 资料存在数据库里,有多少篇、有哪些标签、哪天写的,一条查询就有准确答案,用不着模型去猜。
所以更完整的设计是先分流,再检索:
- 统计、计数、列清单:查数据库,不走检索。
- 带明确范围的问题("九月写的""Git 相关的"):先用时间、标签、文件夹过滤,再在剩下的片段里检索。
- 其余的:走混合检索。
还有一招是查询改写:检索前让模型把问题换个说法,或者拆成几个子问题。它针对的是"用户原话两路都搜不到"的情况,代价是多一次模型调用,而且有可能把问题改歪。
如实说明:分流、元数据过滤和查询改写,EasyRAG 都还没有实现。没做改写是因为三套题集在混合检索下,标注来源全部进了前 5,没有一道题能证明"改写之后才救得回来"。统计类问题则是确定的短板,上面那张截图就是证据。
怎么知道变好了
"感觉变好了"不算数。我是先出题,再改代码。
题分四类:库里有答案的直答题、换了说法的改述题、库里没有的库外题、库里只有一部分的部分覆盖题。每道题标注答案应该出自哪篇文档。29 篇语料里有 12 篇是故意放进去的同主题干扰项,没有干扰项的题集测不出东西。
主要看两个指标。
hit@k:标注的那篇文档有没有进前 k 个候选。它只测检索,不调用回答模型,跑一遍很快,适合反复对比。
错源率:回答里的引用是不是全都落在了标注来源之外。断电丢数据那道题就是靠它抓出来的。那次回答引用格式完全合法,只看报没报错发现不了。
三种策略逐个看。
单用 BM25 最差,第一套题集 22 道题只有 19 道把正确文档排在第一。
纯向量好一些,第一套题集前 5 命中 22/22,第二套 8 道漏了 1 道,就是短卡那道。
混合检索在三套题集上前 5 命中是 22/22、8/8、15/15,错源率从 1/30 降到 0/30。第三套是难例集,有错别字、缩写、中英混用的问法,单用任何一路都有题排不到第一,混合之后 15 道全部排第一。
混合也有变差的地方。有两道题排第一的仍是正确来源,回答却从"完整作答"变成了"部分作答",多了一段覆盖范围的声明。我没有为了这两道题去调参数。
这些数字要打折看。三套题出自同一份语料,题目也参与过调试,全命中只说明这些题找到了标注文档。
写在最后
把上面的内容压成一个做决定的顺序:
- 先用纯向量跑起来,准备一批带标注的问题。
- 找到答错的题,看正确片段丢在哪一步。
- 没进候选:看是不是专有名词、短卡被长文压制这类情况,是就加 BM25,用 RRF 融合。
- 进了候选但排不到前面:接重排。
- 排到了前面但回答不对:改判定和生成。
- 答案根本不在任何片段里:别走检索,查元数据。
检索怎么设计,得扎根在自己的语料和需求上。 我的库里短卡和长文混着放,问题里全是命令名,所以需要 BM25。我的失败是没召回,所以先做混合,没做重排。换一个语料库,每一步都可能得出不同的答案,不变的是先找到失败题再动手。