个人博客开发全记录:从需求到上线全过程
大一下第一次完整拉通一个项目,从灵感、需求、设计、编码到部署上线。Obsidian + GitHub + Spring Boot,博客就这么跑起来了。
个人博客开发全总结:从需求到上线的全过程
这个博客做完了。
从想做一个东西的念头开始,到现在 https://vansye.asia 能访问了。第一次完整拉通了一个项目的全流程,从需求分析到网站备案上线。
说实话,做完之后回头看,觉得最值钱的不是技术,而是那种「我之前什么都没有思路,现在居然真的搞出来了」的感觉。
为什么想做
动机挺实际的。
大一下学了点 JavaWeb,Spring Boot、MyBatis 这些,跟着教程做过几个 CRUD 项目,感觉还行,但总觉得差点什么。面试的时候被问到「你做过什么项目」,我能说的都是那些教程里的东西,没有自己的东西。
然后就开始想:能不能做一个真正属于自己的JavaWeb项目?
有三个具体的想法:
第一,作为一个面试加分项。简历上写「独立完成博客系统开发」,总比只写「完成一个图书管理系统」强。
第二,学点真正的东西。教程里的项目都是别人搭好的架子,你往里填代码就行。但自己做一个的话,需求是模糊的、边界是不清楚的、技术选型是要自己决定的——这种「从零开始」的过程,才是真正学东西的时候。
第三,自己有一个想记录自己学习历程的想法已经很久了,之前是用的obsidian写,然后推送到github仓库,通过贡献图看到一片绿,感觉自己真的每天都在进步,真的很激励自己,随着笔记的变多越来越不方便,然后就想到写博客。
三个联想在一起,所以决定做一个个人博客。
第一个想法:Obsidian 作为数据源
想做大之前,先想清楚一个核心问题:博客的内容从哪来?
我当时用 Obsidian 记笔记,知识库已经有 409 个文件、31.5MB,.md 文件有 224 个。我不想维护两套内容——写一遍就够了,不想在 Obsidian 里写一遍,再在博客后台复制粘贴一遍。
但问题是,Obsidian 笔记是纯 Markdown 文件,博客需要渲染成 HTML、存数据库、提供 API。这两套系统怎么接上?
想了很久,最后有一个想法:
GitHub 就是一个现成的文件同步服务。
Obsidian 有插件叫 obsidian-git,可以自动 commit 和 push 到 GitHub。我的知识库本来就在这个仓库里(private 仓库,只我自己能看)。那如果让博客后端去读这个仓库呢?
思路就清晰了:
Obsidian 写笔记
    ↓  obsidian-git 自动 push
GitHub(传输层)
    ↓  后端拉取 + 解析
博客
不用自己搭文件同步服务,不用搞什么 FTP 或者云存储,GitHub 免费提供了这个能力。
一开始想的是轮询——后端每隔一段时间去检查 GitHub 有没有新提交,有的话就拉下来处理。但后来觉得不太对:GitHub webhook 不就是干这个的吗?推送事件,服务器接收通知,然后处理。这样就不需要轮询了,有变化才干活,省资源。
找到 webhook 的那一刻,感觉这个项目真正「通了」。
设计灵感:从漫画风到 Hermes
做了技术选型,接下来要想:这个博客长什么样?
最初的想法是做一个漫画风的博客。花里胡哨一点,页面上有很多插画、动画、复杂的布局。感觉那种风格很酷,很有人设感。
然后去找 GPT 聊天,描述我想要什么效果。说了一大堆:像素风、漫画格子布局、角色立绘当装饰……聊了很久,越聊越不满意。
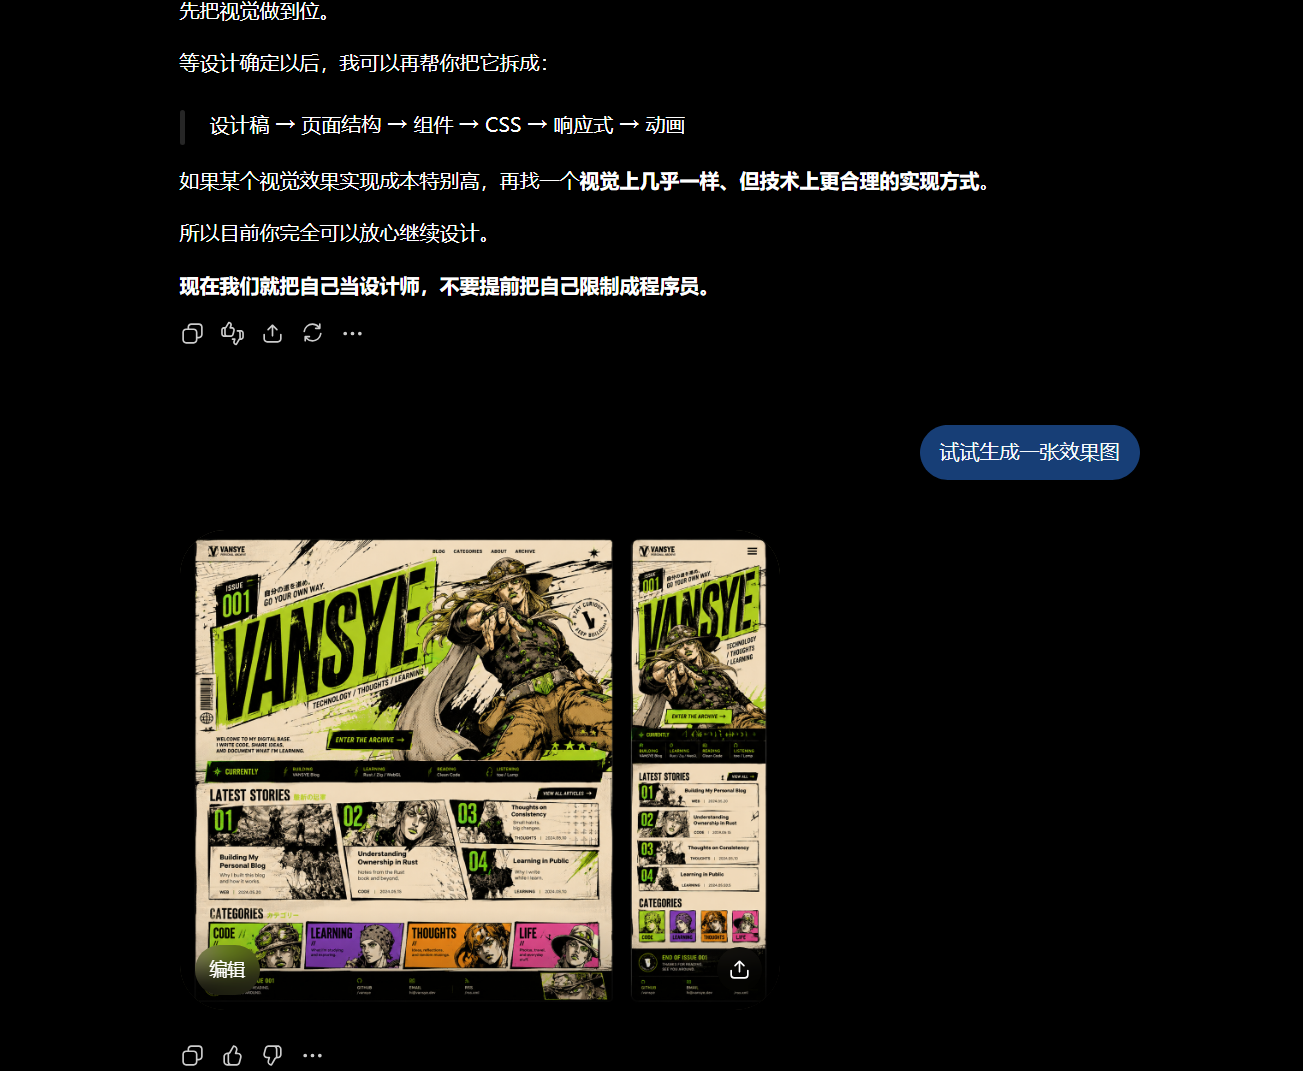
不是它画不好,是我自己也说不清楚我想要什么。描述太抽象了,AI 给出来的方案总觉得差一点意思。
然后就想,去看看别人的博客长什么样。
看了很多 Hexo 主题,看了几个开源的个人博客项目。有的很好看,但要么太复杂自己不是完全需要,要么跟我想的不一样。
后来想起之前看过一个网站:Hermes Agent 的官网(Hermes Agent — Open-Source AI Agent That Grows With You | Nous Research)。那个页面当时给我很大的震撼——极简的配色,但质感很高级。
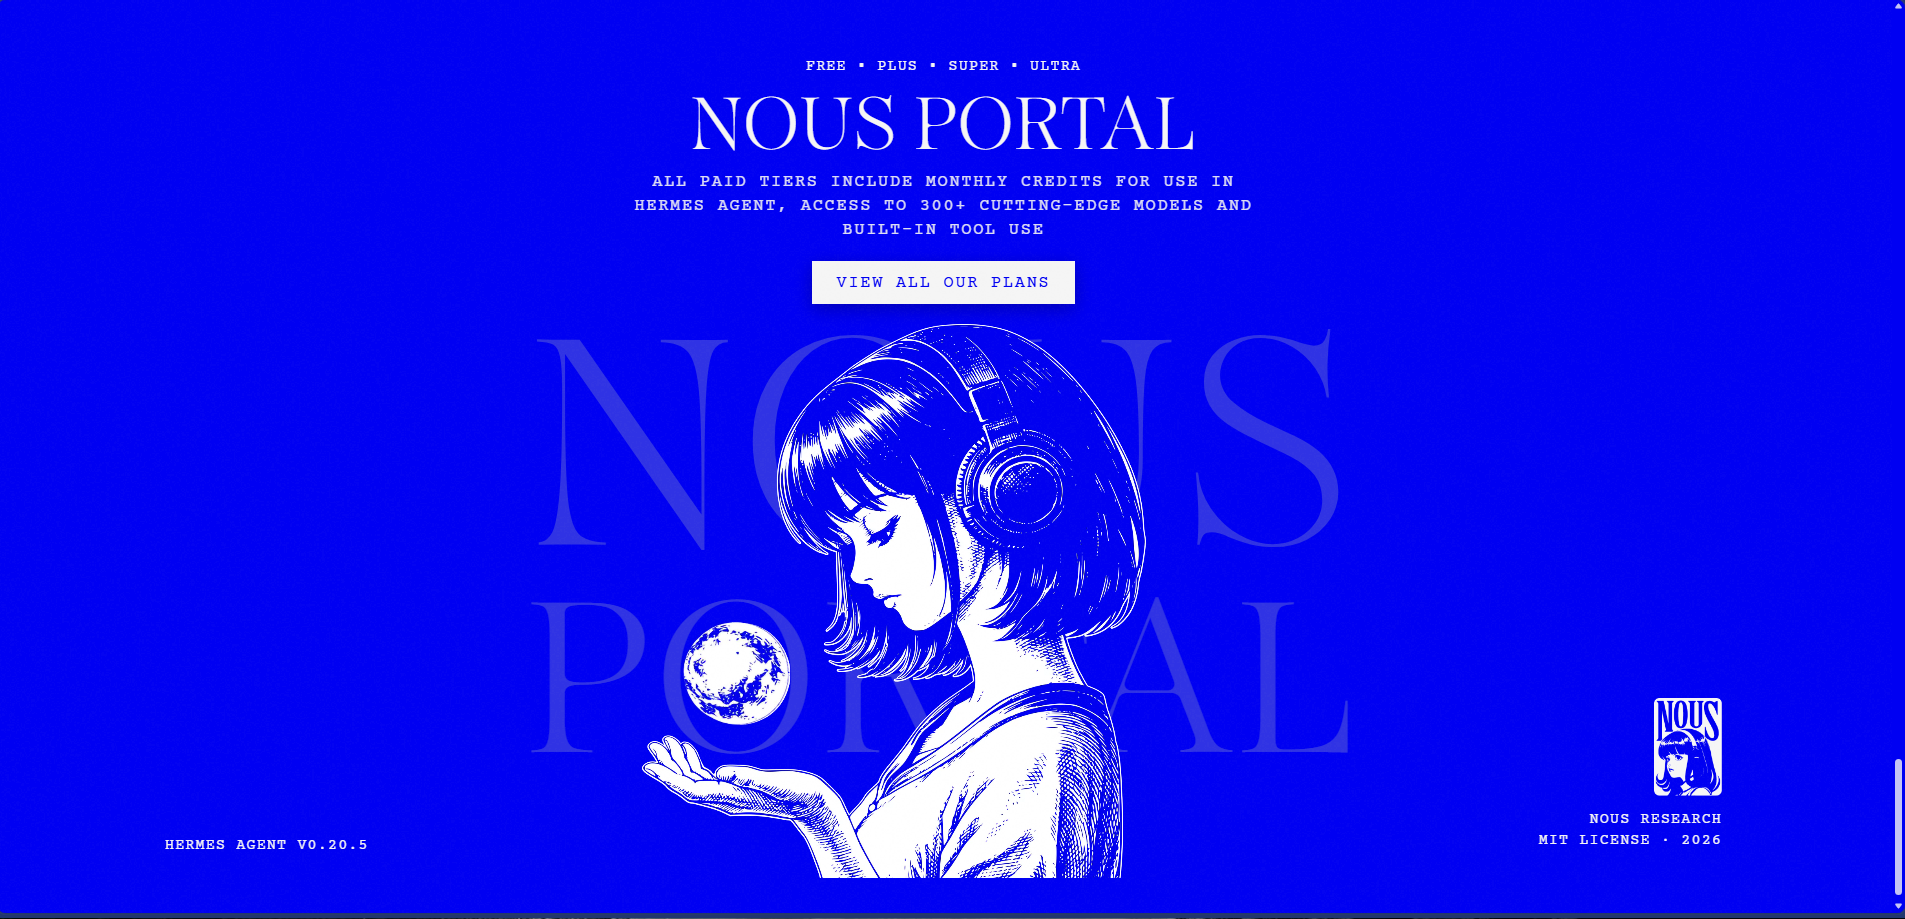
具体是什么感觉我也说不清楚,但就是很想搞清楚它是怎么做出来的。
于是打开 F12,开始扒代码。
看完之后发现,它的「高级感」不是靠复杂的特效,是靠几个很克制的设计原则:
- 全站只有两种密度:奢侈的、缓慢的「图版式」和枯瘦密集的「索引式」
- 配色极度克制:一个主色,一个纸色,文字用不同透明度
- 字体搭配有讲究:衬线字做标题,等宽字做标签,古典的那种字体做正文
- 插画是半透明的,像是压在背景上,不是浮在上面
这些东西说出来好像没什么特别的,但组合在一起就是不一样。
我把这个风格记录下来,然后拿给 GPT 描述,让它帮我生成设计方案。生成的效果比之前好多了——因为我这次不是描述一个模糊的感觉,而是说清楚了「我要什么风格、不要什么风格」。
然后拿这个方案去找 Claude Code,让它生成前端原型。原型出来后我再审,不满意的改,改了再跑,跑了再改。反反复复,最终定下了一个大概模糊的原型。
需求分析:向别人「抄袭」
设计风格定了,接下来要想:这个博客到底要有哪些功能?
我又去看了一圈别人的博客。Hexo 的主题、开源的个人博客项目、还有那些技术博主的博客。看了很多之后,提炼出几个核心需求:
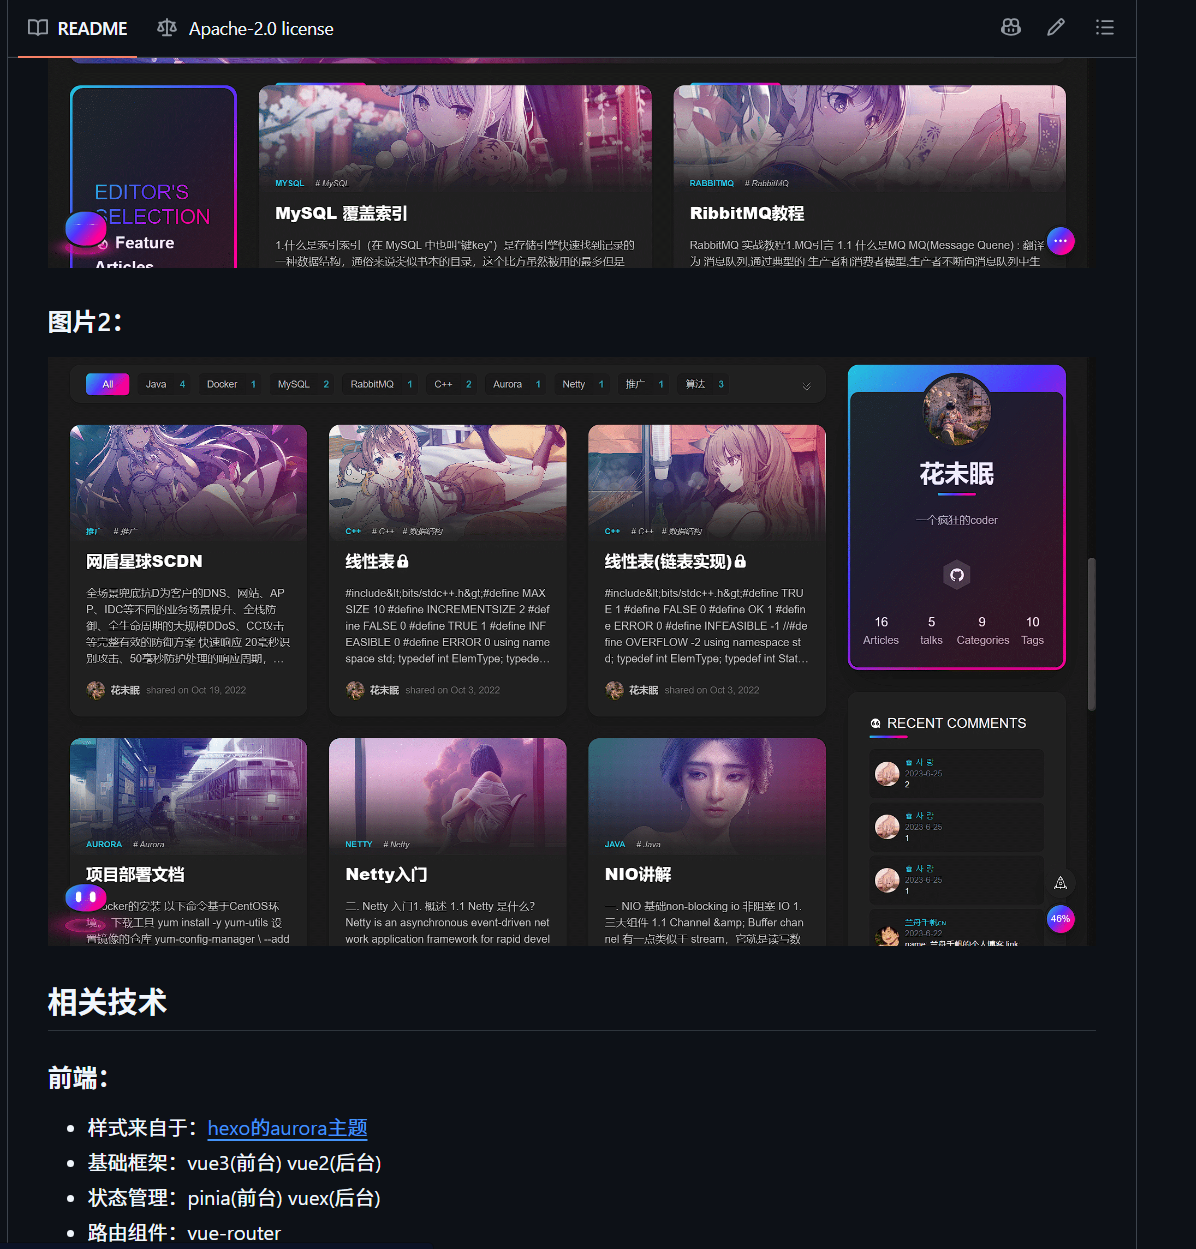
- 首页要有精选文章,让人一眼能看到最新内容
- 文章页要能正常显示 Markdown 渲染的结果,代码块、图片、表格都不能出问题
- 要有归档页,按时间浏览历史文章
- 要有 About 页,介绍自己
- 发布机制要简单——写完 push 上去,博客自动更新
然后开始写 PRD(产品需求文档)。
写 PRD 之前,我先把核心需求列出来,大概就三句话:
- vault 是唯一内容源,数据库是派生读模型
- 发布闸门必须 fail-closed,三条规则同时满足才能发布
- GitHub 是传输层,不另造同步通道
这三句话定了之后,才开始慢慢补充细节。比如:图片怎么处理、字段缺失怎么降级、删除文章是软删除还是硬删除、webhook 重复投递怎么办……
每一条规则后面都要想清楚:如果这件事做错了,后果是什么?
比如发布闸门,如果判定逻辑写错了,可能把不该发布的笔记放出去。而我的知识库里有 个人/ 目录下的笔记,里面有一些不想公开的内容。所以发布闸门必须足够严格,宁可错杀也不能放过。
PRD 写了很久,改了很多版。从最初的几行,到最后几万字的文档。但这个过程很有价值——把模糊的想法变成明确的规则,写代码的时候才知道在做什么。
核心设计:三条铁律
最终定了三条铁律,作为整个项目设计的裁判。
铁律一:vault 是唯一内容源
博客数据库里除了阅读量和图版号之外,其余所有内容都必须能从某个 git commit 完整重建。
这条铁律换来的是:
- 不需要冲突解决——单向流,没有并发写
- 灾难恢复 = 清库 + 全量重扫,不需要备份内容
- git 免费提供了版本历史、diff、回滚
- 「博客上的内容和我本地不一致」这类 bug 在结构上不可能发生
代价是:博客后台不能编辑内容。这是主动选择,不是能力缺失。
铁律二:发布闸门 fail-closed
一篇 md 文件只有在同时满足以下三个条件时才发布:
- 路径命中允许清单(
博客/文章/、博客/随笔/、博客/项目/、博客/关于.md、博客/友链.md) - frontmatter 有
publish: true(显式、无默认值) - 路径未命中禁止清单(
个人/**、**/草稿/**、**/_模板/**等)
三条是 AND,禁止清单优先级最高、覆盖一切。任何一条判定不了 → 不发布,并记入同步日志。
为什么要三重而不是只靠 publish: true?因为我的知识库里有 个人/个人信息/** 这类私人的东西。单点判定一旦写错、或者哪天模板文件带上了 publish: true,后果是不可撤销的——搜索引擎已经抓走了。这里的冗余是故意的。
铁律三:GitHub 是传输层
不新造一条同步通道。obsidian-git 已经在自动 commit + push,博客只需要消费这个已经存在的事实。
好处:不需要在我的机器上常驻任何新进程;换电脑不用重新配;离线写作照样在联网后自动补上。
代价:发布延迟 ≈ obsidian-git 的提交间隔 + webhook 处理时间。实测要是我写完一篇博客要是我忘记手动推送的话就只有默认自动推送是20个小时一次,但实际上自己一般写完肯定是默认想要臭美一下发布的,所以问题不大。
同步流程
整个同步管道的逻辑是这样的:
GitHub webhook 推送
    ↓
验签(HMAC-SHA256)
    ↓
Redis SETNX 抢同步锁(防重复投递)
    ↓
git fetch + diff → 变更文件清单
    ↓
逐文件过发布闸门
    ↓
过闸的:解析 frontmatter → 渲染 Markdown → upsert 到 MySQL
    ↓
没过闸的:记入同步日志(skipped_json 写明原因)
    ↓
失效 Redis 缓存
webhook 不保证只投递一次,所以用 Redis 锁防止并发。同一个 commit 同步多次的结果必须和同步一次完全一致,这个用 content_hash 比对来实现幂等。
还有一个轮询兜底。默认关闭,部署时打开。定时比对 HEAD 与「上次完整同步到的 commit」,不等则跑一次全量。自动覆盖四种情况:投递丢了、进程没在跑、撞锁回了 202、上次是 partial。
发布闸门:最核心的一块
这是写测试最多的模块。
发布闸门的逻辑很简单:一个 md 文件路径 + frontmatter 内容 → 能不能发布。
但实际实现时发现边界比想象的多,这一部分写了巨多的测试。需求里写的是三句话,看起来很好判。但真正画取值谱的时候,挖出了不少暗含的边界。
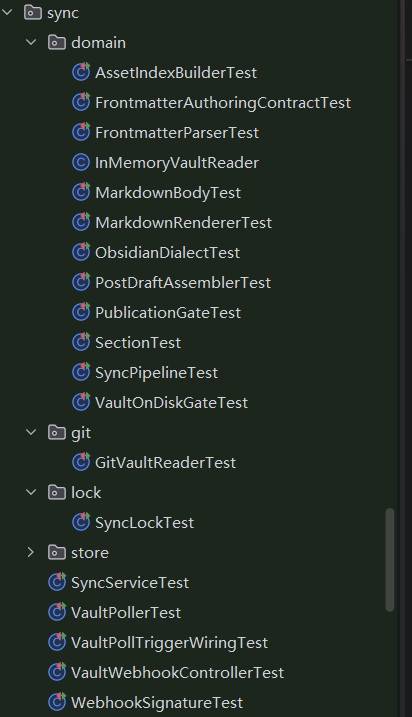
比如路径同时命中允许清单和禁止清单怎么办?需求里说「禁止清单优先级最高」,但没有说代码里哪个判断先跑。如果顺序写错了,结果虽然也是拒绝,但拒绝的原因码会错——这个码会进同步日志,错了就等于排查时被误导。
再比如 publish: true 这个字段,需求说「显式、无默认值」。那 publish 字段缺失算什么?不是 false,是「判定不了」,应该不发。但如果用 boolean 类型接这个字段,就没法区分「写了 false」和「根本没写」——只能靠 Boolean(包装类)让 null 表示缺失。
为了覆盖这些边界,发布闸门模块写了 13 个单元测试,代码 113 行,测试 129 行。测试比实现多,对这个模块来说很正常——判错的后果是隐私笔记泄漏,这类代码不值得省测试。
一个真实踩过的坑
最初写禁止清单的时候,我把 博客/草稿/ 当作具体路径。但需求里写的是 **/草稿/**,意思是任意层级。差出来的地方是:博客/文章/草稿/未完成.md 会被旧代码放行。
这个漏洞的成因不是粗心,是流程问题——写清单时凭的是对需求的印象,没有回去逐字对原文。转述的过程中,「任意层级」这个信息量最大的词被丢掉了。
教训:把需求里的清单、枚举、边界条件抄进代码时,逐字对照原文,不要凭记忆。这类信息丢失不会报错、不会让测试变红,只会在某个你没想到的输入上安静地放行。
附件问题:图片裂开
Obsidian 我设置了一个默认行为:粘贴截图会自动放到 _附件/ 目录。
但我发现这个目录不在 git 白名单里。结果是文章引用了图片,但图片没跟着 push 到 GitHub,博客上图片全部裂开。
当时发现的时候,那篇《低空略过 Redis 的学习》就是这种情况——3 张图片一张都没有。而且这篇文章连 frontmatter 都没有,正文开头是几个 tab 加一条 --- 水平分隔线,不是 YAML 块。
解决方案是在 Obsidian 设置里把附件默认位置改为「当前文件所在文件夹下的 _assets 子目录」,然后在 .gitignore 里白名单放行 博客/文章/_assets/。这样附件和文章同生共死,边界干净。
图片在服务端按内容哈希存,URL 是 /assets/<sha256前16位>.png,不暴露 vault 路径。好处是天然去重、可以永久缓存、改图必然换 URL 不会被 CDN 卡住。
取字节按 git blob id,不按 vault 路径。因为位置到内容的映射会变——同名覆盖一张图之后旧 URL 就指不到任何东西了。而 git 对象库本身就是内容寻址的,asset 表存一列 blob_id,取图直接 repository.open(blobId)。
一个真实的发现:SnakeYAML 的布尔词表
SnakeYAML 解析 frontmatter 的时候踩过一个坑。
我以为 YAML 2.x 已经把布尔词收窄到只剩 true/false,写了一条测试断言 publish: yes 应该判定不了。跑出来是红的:
expected: null but was: true
SnakeYAML 2.4 沿用 YAML 1.1 的词表,yes / Yes / YES / on / On / ON 全都是货真价实的 Boolean.TRUE。
这时候有两条路:改代码去迎合我的假设,或者改断言去承认事实。选了后者,同时留了一条用例把反直觉的那半边钉死:publish: "true" 加了引号就是字符串,不发布。
这个发现让我记住一件事:你对第三方库行为的「我记得是这样」,和它的实际行为,是两件不同的事。写一条断言去问它,比翻文档快,而且答案不会过期。
前端:手写 HTML + CSS
前端是纯静态页,没有框架,没有构建工具。
首页、归档页、文章页,都是直接写的 HTML + CSS,总量不到 800 行。
视觉风格就是之前扒 Hermes 官网定下来的那个方向。全站只有两种密度:
图版寄存器:奢侈、缓慢、一屏一事。用于首页、About。
索引寄存器:枯瘦、密集、纯文字表格。用于归档、列表、页脚。
配色只用了两个色:主背景紫色 #7929FF 和纸面白 #F4F2F8。文字用白色和深墨紫 #2B1670。全站不允许出现第三个色相,状态用透明度表达而不是颜色。
字体三个角色:展示字用 Libre Caslon Display(衬线),标签字用 Courier Prime(等宽),内容字用 Noto Serif SC(宋体)。中文用宋体不用黑体,是为了配合那个「博物图录」的年代感。
数据库:五张表
数据库里只有五张表:post、asset、sync_log、plate_seq、tag。
post 存渲染后的文章,asset 存图片等附件,sync_log 记每次同步的日志,plate_seq 管图版号,tag 管标签。
表结构很简单,因为内容都来自 git,数据库只是读模型。如果需要重新生成全部内容,删库重来就行——git 里有完整的历史。
一个容易踩的坑:图版号查询要用 CAST(plate AS UNSIGNED)。plate 是 VARCHAR,字符串比较下 '1000' < '999',直接 MAX(plate) 会在跨过 999 那一刻开始重号——表现为「第 1000 篇永远发不出去」且看不出原因。尽管这个坑我觉得可能基本坑不到我,当然要是坑到了那也是我的荣幸了,哈哈哈哈哈。
部署:8 个脚本
部署用了一组脚本,按编号顺序跑,每个脚本幂等(重复执行不会弄坏已配好的东西)。域名备案大概花了两周,云服务器、域名、ICP 备案这些东西是第一次接触,一边查一边学。
不能浅克隆。 用的完整 clone,不是 --depth 1。两处都依赖历史:计算文章日期要拿每个文件的首次提交时间;取图按 git blob id 从对象库拿字节,旧版本的图要靠历史里的对象。浅克隆的症状不是启动失败,是「文章日期全是今天」加「部分图 404」——两个都不像克隆参数的错。
凭据不进 git。 应用启动时当场问密码,写进系统配置文件,仓库里任何文件都不含明文密码。原来配置文件放在 src/main/resources/ 下,Maven 把它打进了 jar,scp 上服务器的那个 jar 里带着本机明文密码。后来改到 blog/config/,在 Spring Boot 的默认搜索路径里,所以本机照样读得到,而它不在构建树里、进不了 jar。
内存预算也要单独算。2 GiB 的服务器,扣掉内核和保留区大概只剩 1.6G 左右。JVM、MySQL、Redis、nginx 四个服务加一起大概 1G,还有 600M 左右的余量。JVM 加了 systemd 的内存限制,防止它涨上去把 MySQL 挤掉——那样症状是「数据库没了」,但根因是 JVM 内存泄漏,排查会从错的地方开始。
开发节奏:分三步走
整个项目分了三个部分,每部分零外部依赖,可以独立测试:
第一部分:PublicationGate 等等边界条件控制文件。这部分只管「一个 md 文件能不能发」,不连数据库、不 clone 仓库、不发请求。
第二部分:MarkdownRenderer + AssetIndex + PostDraftAssembler。补上了字段降级策略和 content_hash 计算。
第三部分:SyncService + VaultWebhookController + VaultPoller。接上了 JGit、MySQL、Redis。
每部分做完再进下一部分,不是因为前一部分做不好,是把每一步考虑细点不至于后面堆成“屎山”。
最后的感受
从一个想法变成一个实际的东西。不是dome,也不是简单的“本地主人”上的Javaweb 是一个实打实上线的项目。
技术上可能感觉没什么高深的,也就是做了一个简单的流程嘛:Obsidian 写笔记,GitHub 传输,Spring Boot 同步和渲染,MySQL 存读模型。
但这个过程里学到的东西,比教程里的多得多。
最值得记住的一条经验是:需求里的形容词和副词后面,一定藏着边界。凡是出现「必须」「优先」「任何」「唯一」这些词,回去问一句「反面是什么」,把那个反面写成测试用例。这样写出来的代码不会漏掉需求里暗含的情况。
还有,禁止清单和允许清单的判定顺序,一定要写在代码注释里,最好配一张决策表。不然将来有人来改这段代码,不知道怎么调顺序,顺手一改就可能放出一篇不该发的笔记。
其实最大的收获不是技术上的,而是那种「我之前什么都没有思路,现在居然真的搞出来了」的感觉。从需求分析到网站备案上线,整整一条链路都走通了。真的感觉带来的很多成长和感动,我也相信这个个人博客能继续陪着我继续面对下一个新知识。
以后再面对一个新项目,不会再是从零开始的迷茫,而是知道该从哪一步开始。
2026-08-24